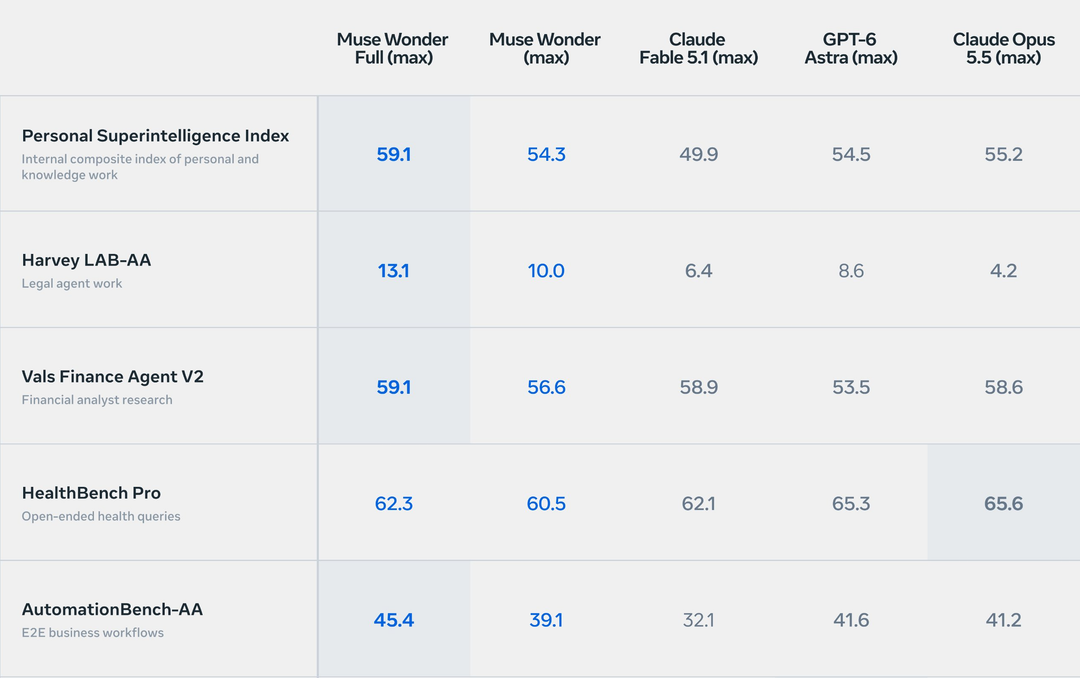
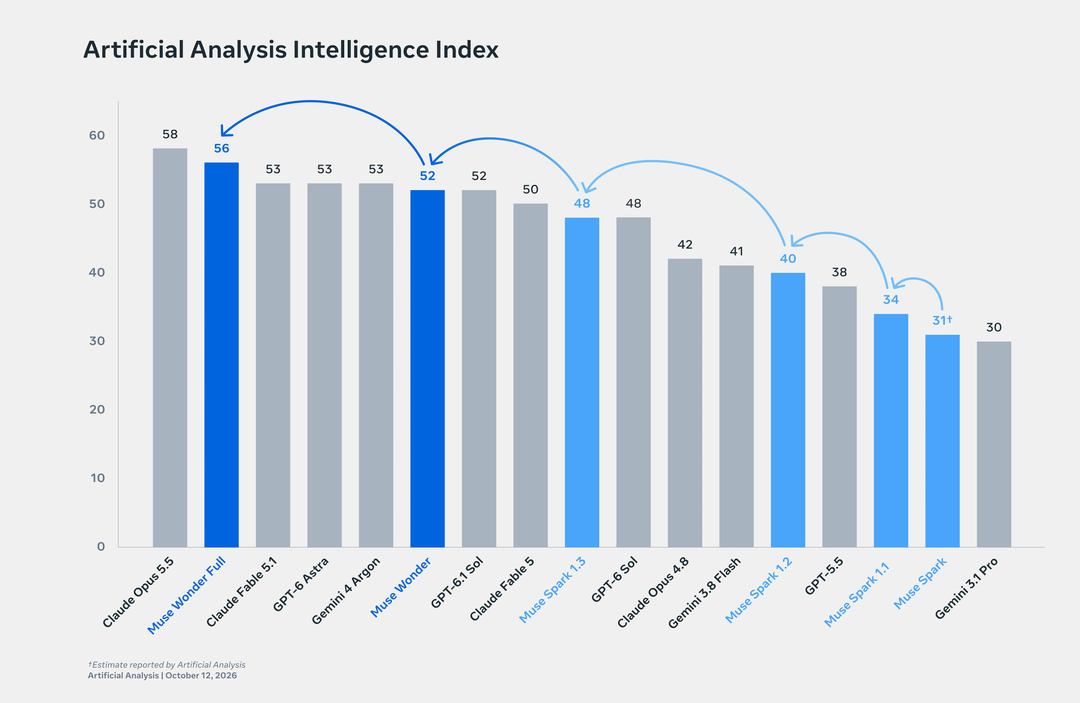
1、Meta 发布 Muse Wonder 系列旗舰 Agent 模型,最高智能指数达 56 分;
2、SpaceXSI 推出整合式订阅 The X Subscription,合并 Grok、Cursor 与 X Premium 权益;
3、OpenAI 完成第 8 轮 Codex 用量重置,Agents API 新增沙箱预热功能。
4、智谱推出法律专用模型 GLM-Legal,OpenBMB 开源 MiniCPM-V 4.7 多模态系列。
5、技术研究密集推进:Anthropic 验证小模型自我复制可行性、公布蒸馏攻击防御效果;
6、Karpathy 指出 LLM 能力认知差距持续扩大;千问推出 QwenGyre 超长程强化学习框架。
7、产业端微软 Maia 计划扩至数千兆瓦部署,英伟达开放 Vera Rubin 机架设计,AMD 发布新一代锐龙 AI Halo 开发者平台。
一、模型发布与开源
1. Meta 发布 Muse Wonder 系列 Agent 模型
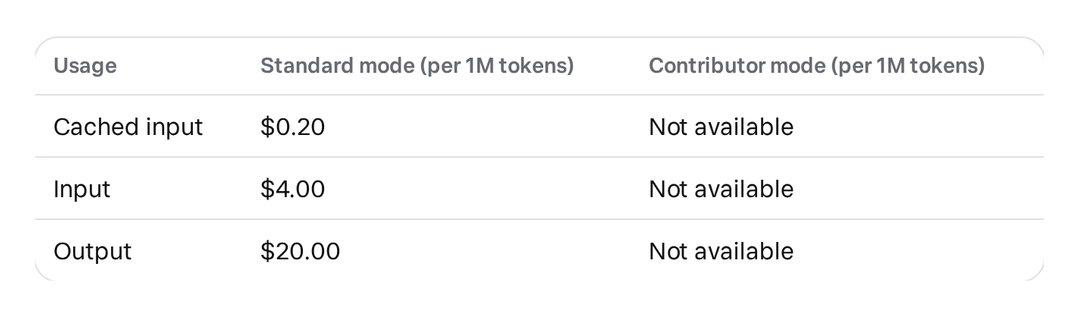
Meta 正式发布Muse Wonder与Muse Wonder Full两款模型,面向个人与专业 Agent 任务场景。 核心升级:新增Active Memory跨对话记忆功能,可跨会话保留用户重要信息;Active Focus主动聚焦机制,复杂任务中自动尝试替代方案、处理障碍,重要行动前向用户确认。 两款模型均支持文本、图像、视频、音频多模态输入,上下文长度 100 万 Token。 Muse Wonder 已通过 Meta Model API 与 Muse Code 开放,API 定价:输入 4 美元 / 百万 Token、缓存输入 0.2 美元 / 百万 Token、输出 20 美元 / 百万 Token;Muse Wonder Full 目前仅面向 Muse Code 订阅用户开放。 Artificial Analysis 评测中,两款模型智能指数分别为 52 分与 56 分,高于上一代 Muse Spark 1.3 的 48 分;Muse Wonder 单任务平均成本约 4.52 美元。
官方博客:https://research.meta.ai/blog/muse-wonder 模型卡片:https://research.meta.ai/static/muse-wonder-model-card 定价说明:https://dev.meta.ai/docs/pricing-rate-limits
2. 智谱推出法律专用模型 GLM-Legal
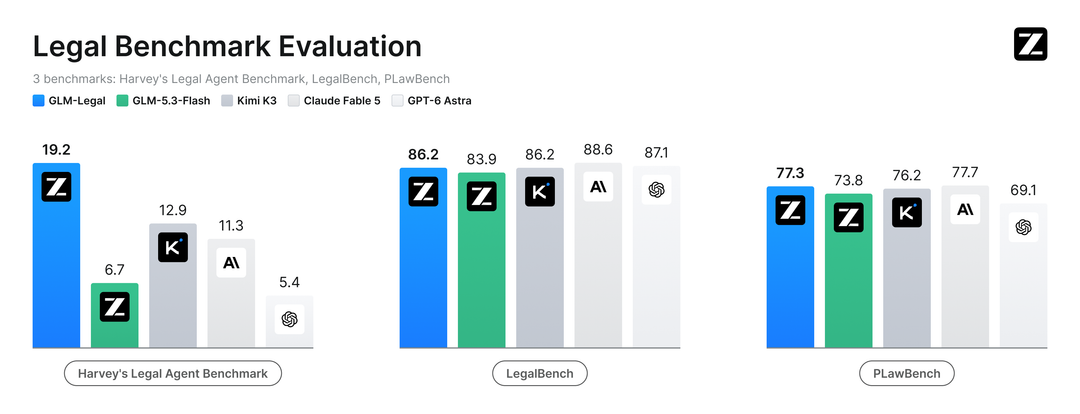
智谱推出基于 GLM-5.3-Flash 微调的法律场景专用模型GLM-Legal,面向合同审查、证据分析、合规研究等法律工作流。 官方评测显示,模型在 Harvey LAB 基准全通过率达 19.2%,较基座模型提升 12.5 个百分点;在 LegalBench、PLawBench 基准上,以显著更小的参数规模追平前沿闭源模型表现。 目前模型处于测试阶段,API 访问需申请;相关能力即将接入桌面 Agent 平台 AutoClaw。
官方博客:https://z.ai/blog/glm-legal 官方动态:https://x.com/Zai_org/status/2109678174468534511
3. OpenBMB 发布 MiniCPM-V 4.7 系列多模态模型
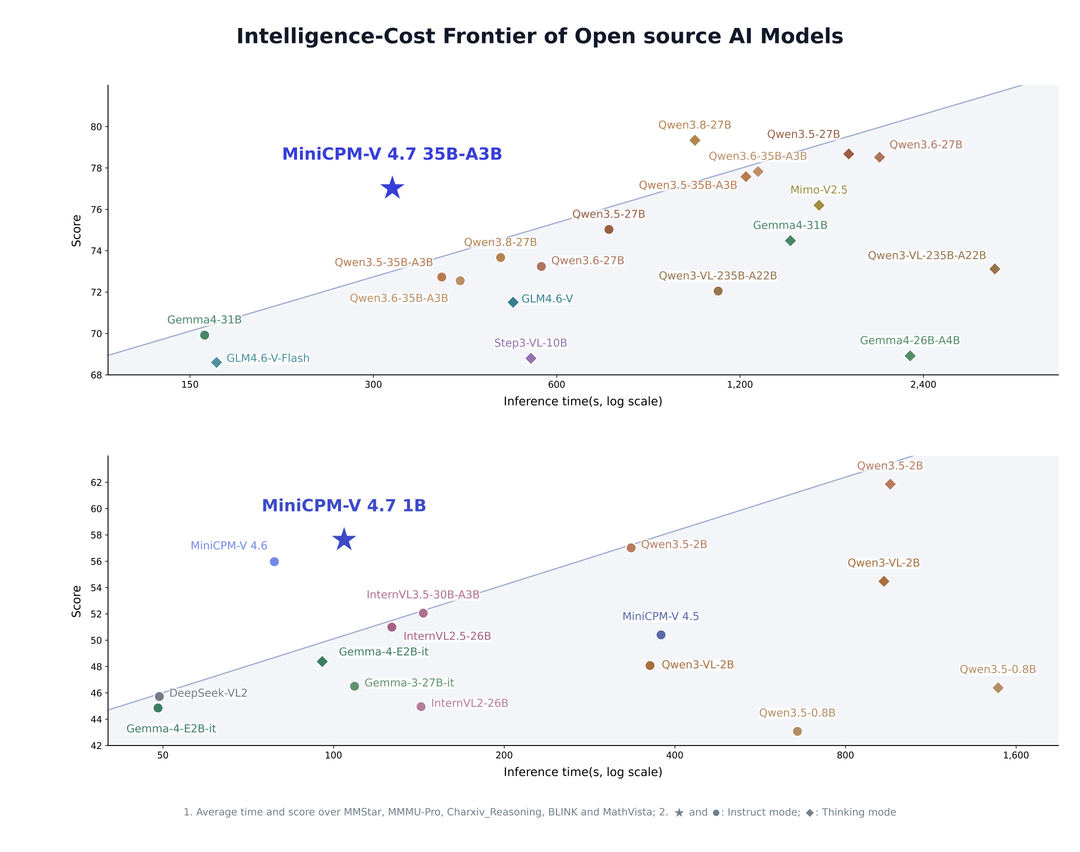
OpenBMB 正式发布并开源MiniCPM-V 4.7系列多模态模型,包含 35B-A3B 与 1B 两个型号,支持单图、多图、文档与视频理解,适配手机、平板与本地设备部署。 35B-A3B 版本引入LES(层预测预加载)技术,预测并预加载下一层专家权重,减少推理等待;官方测试显示,在 iPhone 17 Pro Max 上解码速度超过 13 token/s,内存占用约 3GB。 全系列支持 4 倍、16 倍混合视觉 Token 压缩,配套Self-Replay Fine-Tuning微调方法,低成本扩展能力同时减少遗忘。 模型、代码与权重以 Apache-2.0 许可开源,支持 iOS、Android、HarmonyOS 端侧部署。
项目仓库:https://github.com/openbmb/MiniCPM-V 模型权重:https://huggingface.co/openbmb/MiniCPM-V-4.7-35B-A3Bhttps://huggingface.co/openbmb/MiniCPM-V-4.7-1B
二、开发生态与工具更新
1. SpaceXSI 推出 The X Subscription 整合订阅
SpaceX Super Intelligence 正式推出统一订阅方案The X Subscription,将 Grok、Cursor、X Premium 整合为同一订阅、工作空间与账单体系。 付费档位分为 Plus(8 美元 / 月)、Premium(30 美元 / 月)、Super(100 美元 / 月)、Ultra(200 美元 / 月)四档,后三档包含额度分别为 Plus 档的 4 倍、15 倍、50 倍;Premium 及以上档位包含 Grok Bot 与完整 X Premium + 权益。 每个席位的每周额度由 Grok、Cursor 等第一方产品共用;Cursor 中的 Claude、GPT 等第三方模型不计入订阅额度,按 API 标价另行付费,第一方超额使用需额外充值。 新用户直接使用统一订阅;现有 Cursor、SuperGrok、X Premium 用户可保留原方案,切换后不可撤销。
2. Codex 完成第 8 轮用量重置
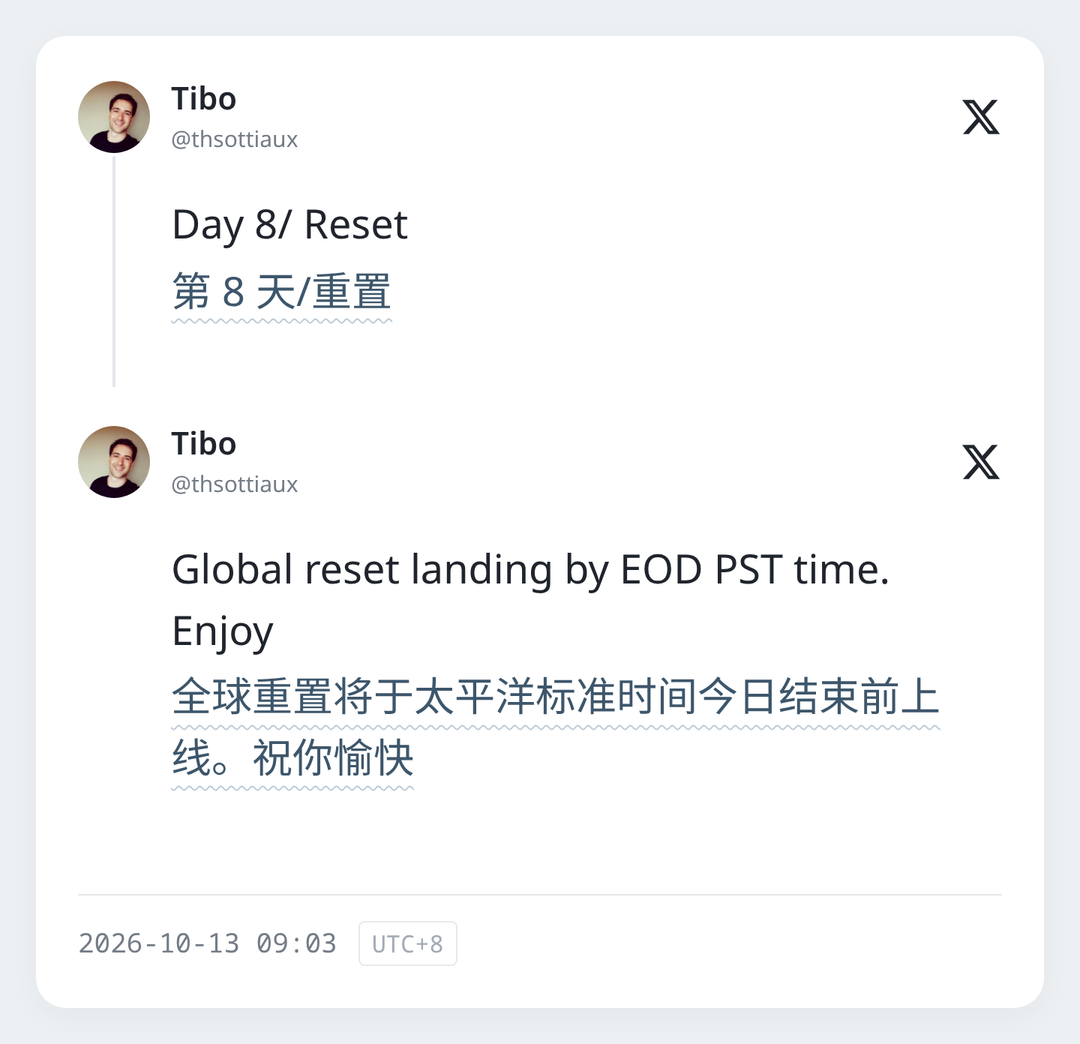
OpenAI Codex 负责人 Tibo 宣布,28 天更新计划的第 8 天完成全局用量额度重置,重置在太平洋标准时间 10 月 13 日结束前完成。 此前官方承诺,未来 28 天内每天为多数 Codex 与 Work 用户推出一项功能改进或完整额度重置。
官方动态x.com/thsottiaux/status/2109812216212099456
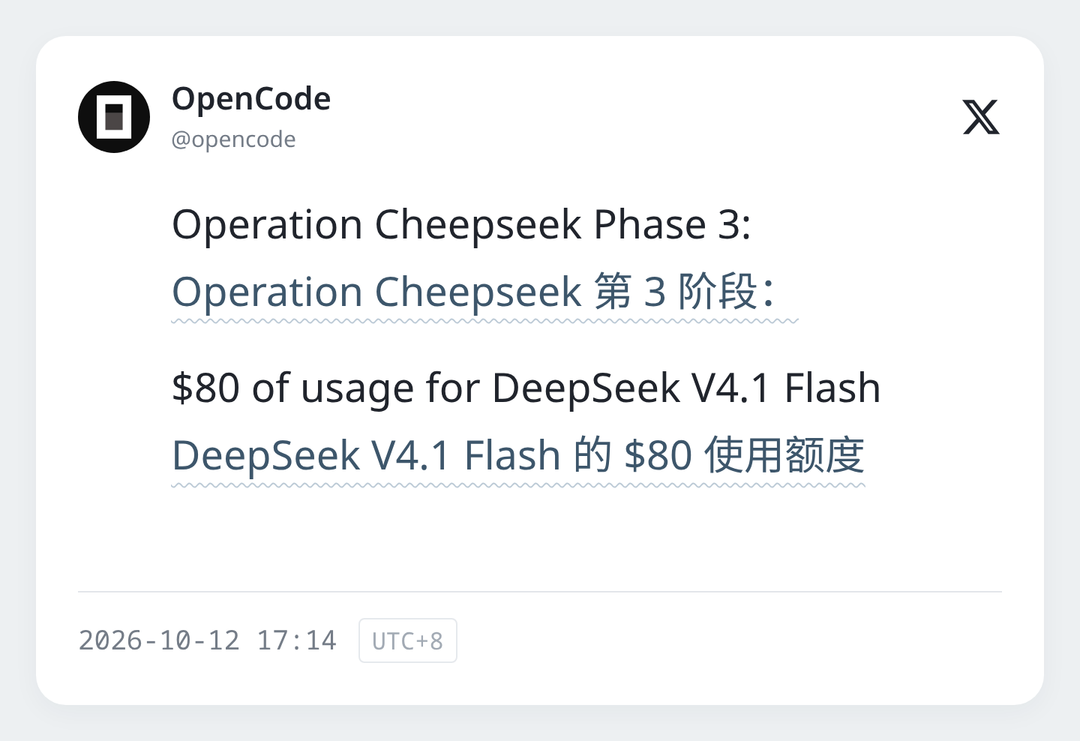
3. OpenCode Go 提供 80 美元 DeepSeek V4.1 Flash 额度
OpenCode 宣布 Operation Cheepseek 第三阶段福利:OpenCode Go 订阅用户可获得价值 80 美元的 DeepSeek V4.1 Flash 使用额度。
官方动态x.com/opencode/status/2109573342584058065
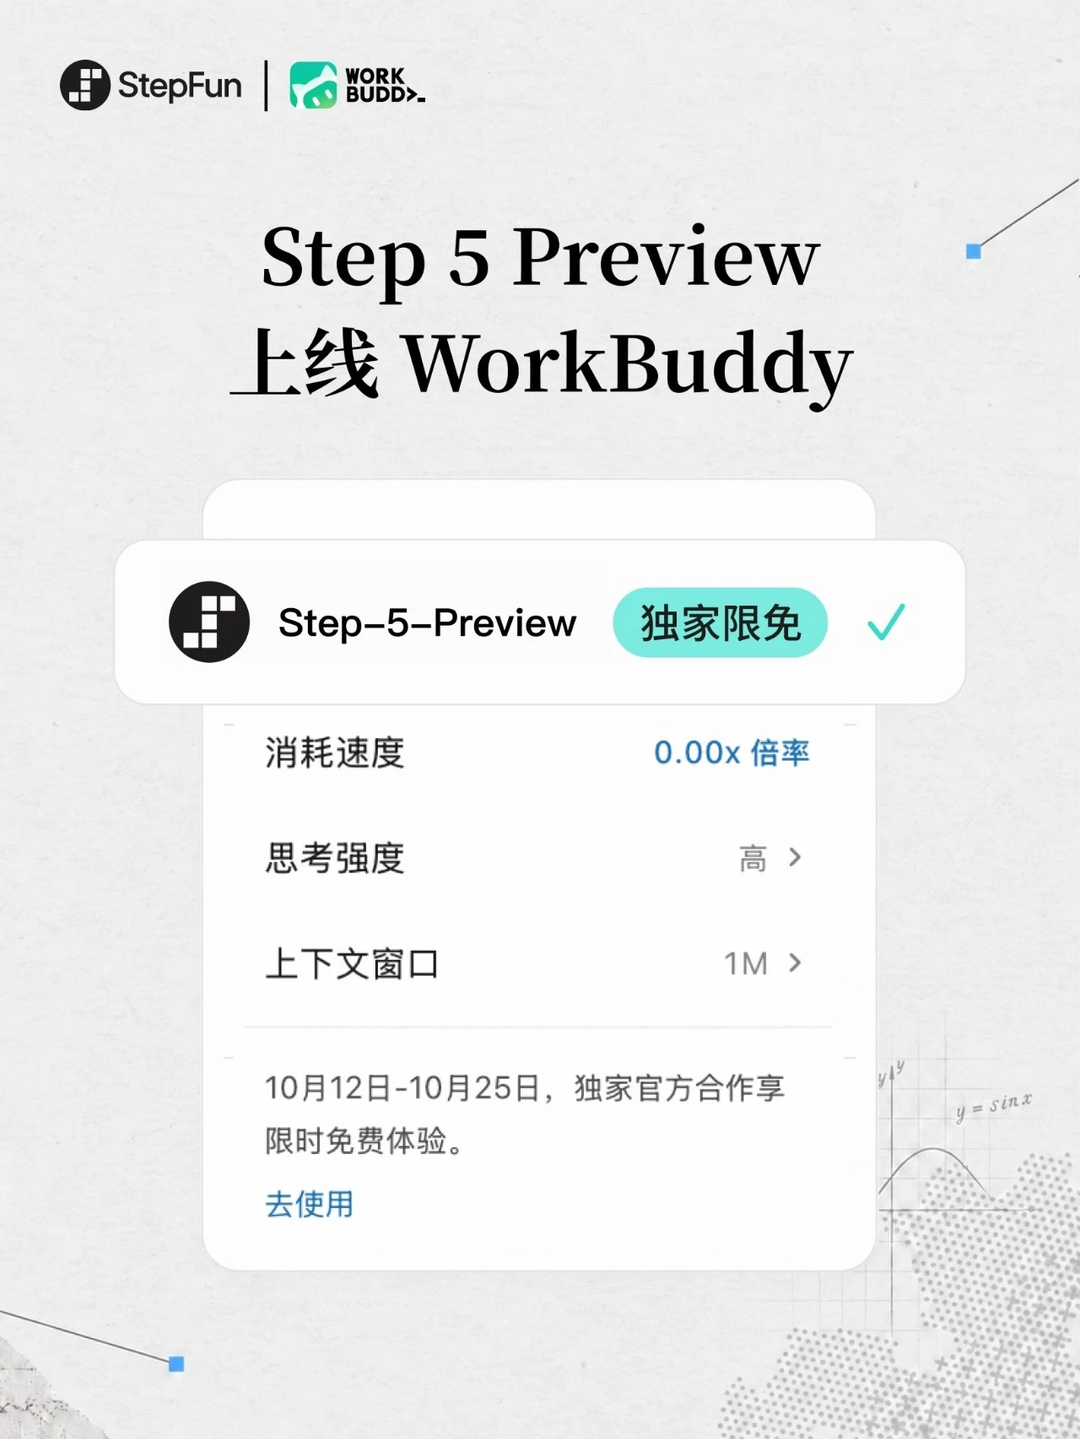
4. 阶跃 Step 5 Preview 上线 WorkBuddy,独家限免两周
阶跃星辰 Step 5 Preview 模型正式上线腾讯 WorkBuddy 全场景 AI 办公工作台,2026 年 10 月 12 日至 10 月 25 日期间独家限免两周。 官方表示,该模型将更强的推理与 Agent 能力带入办公场景,覆盖深度研究、信息检索、数据分析、文档与 PPT 生成,以及多步骤复杂任务持续执行。
官方公告mp.weixin.qq.com/s/VmJfCg7X7niy0m9JD6mCdg
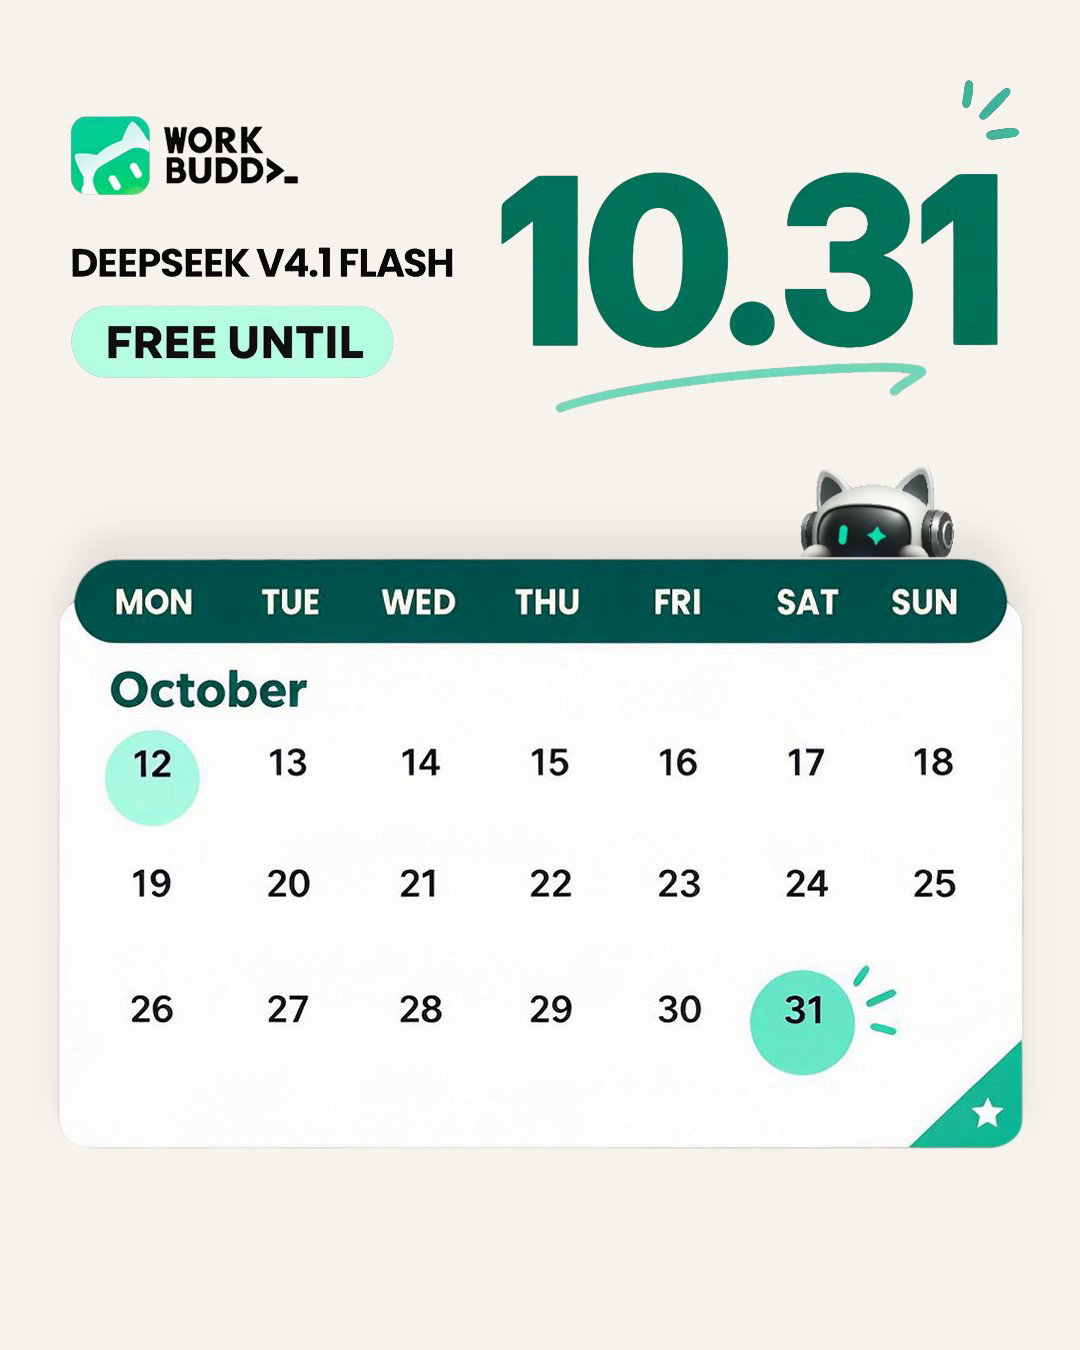
5. DeepSeek V4.1 Flash 在 WorkBuddy 国际版免费至 10 月 31 日
WorkBuddy 国际版宣布,DeepSeek V4.1 Flash 模型的平台免费访问延长至 2026 年 10 月 31 日,响应用户需求。
官方动态x.com/WorkBuddy_AI/status/2109673559710974130
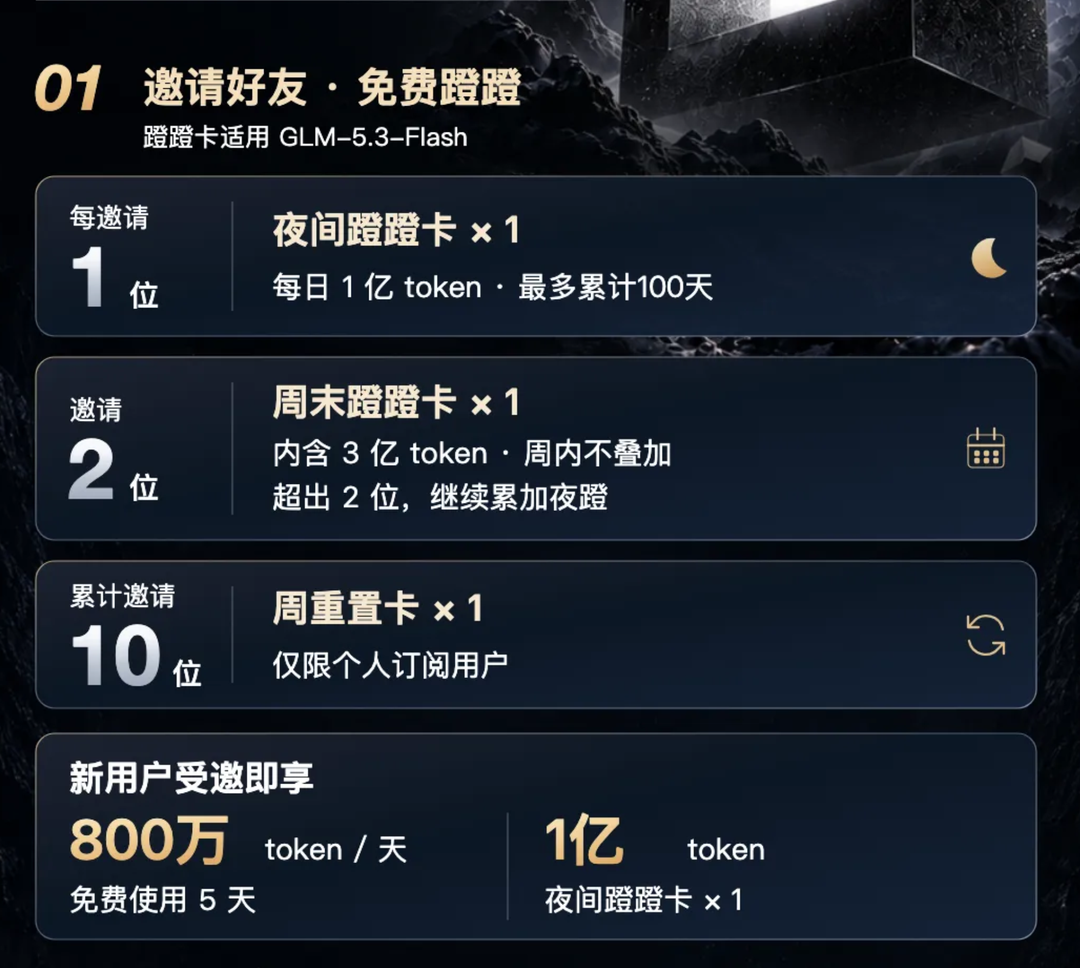
6. ZCode 推出邀请好友活动,最高累计奖励 100 天
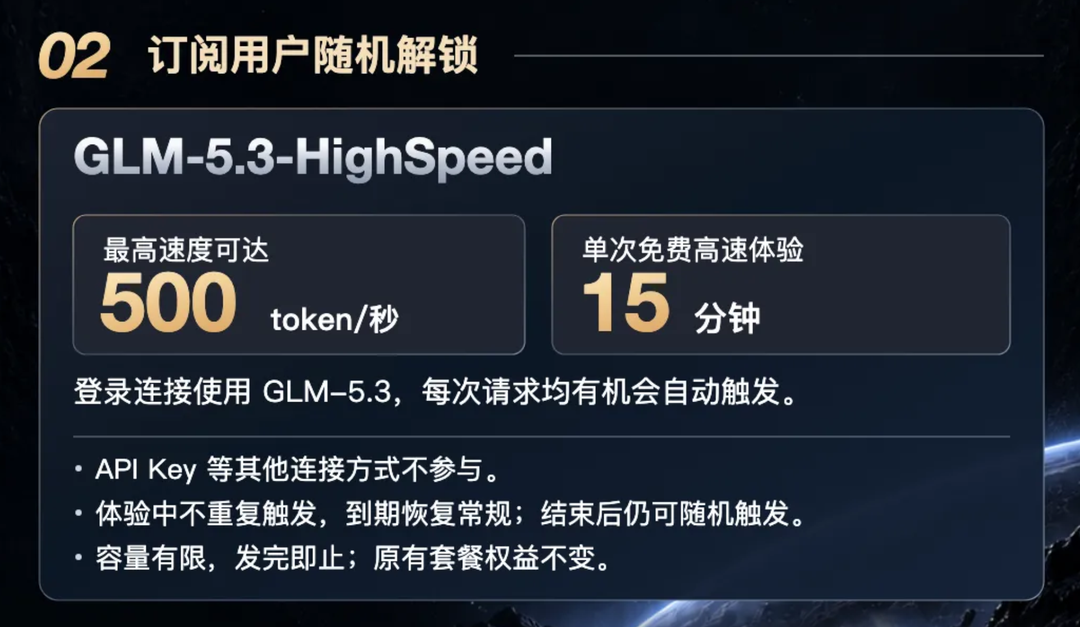
智谱 ZCode 推出邀请好友活动,时间为 10 月 12 日至 11 月 13 日,奖励适用于 GLM-5.3-Flash 模型。 每成功邀请 1 位好友可获得 1 张夜间蹭蹭卡(每日额度 1 亿 Token,最多累计 100 天);邀请 2 位可获得 3 亿 Token 周末蹭蹭卡;个人订阅用户累计邀请 10 位可获周重置卡。 受邀新用户可获得连续 5 天、每天 800 万 Token 免费额度,以及 1 亿 Token 夜间蹭蹭卡。活动同步开放订阅用户随机体验 GLM-5.3-HighSpeed 的机会,单次免费 15 分钟,速度最高 500 token/s。
活动页面:https://zcode.z.ai 官方动态:https://x.com/zcode_ai/status/2109678026971861370
7. OpenAI Agents API 新增沙箱预热功能
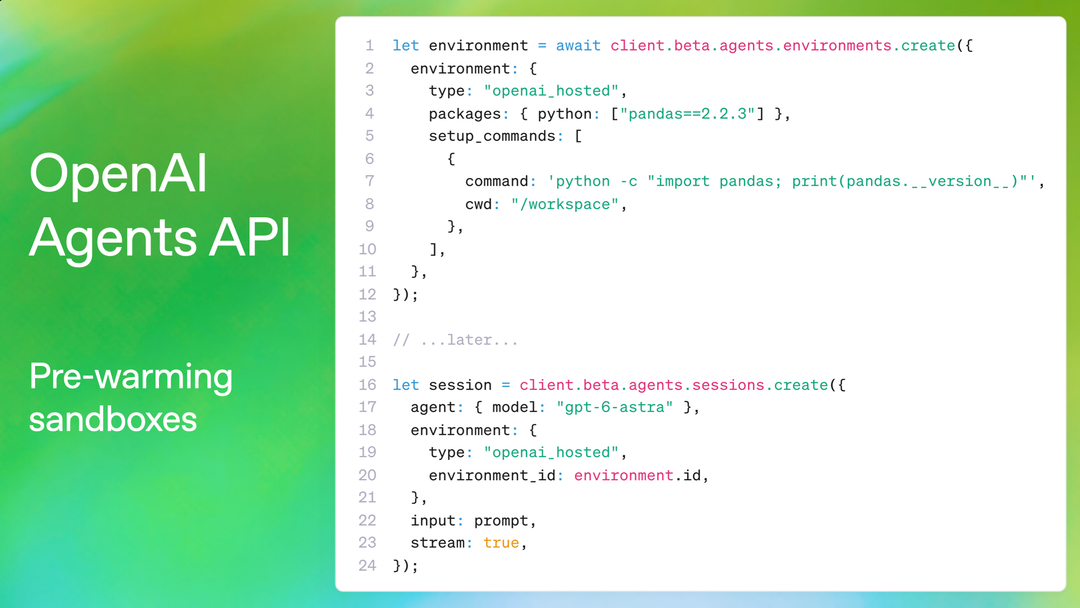
OpenAI 为 Agents API 新增沙箱预热(Prewarmed environments)功能,开发者可在 Agent 会话创建前预先安装依赖包、加载文件、运行初始化命令,减少任务启动等待时间。 任务到来后,可将准备好的托管环境接入会话;若初始化未完成,Agent 仍需等待才能使用工作空间。 预热及接入前的容器使用免费,接入后按标准容器价格计费;未接入的环境约 5 分钟后过期。新建独立环境支持最多 128 个会话共享工作空间。
官方文档developers.openai.com/api/docs/guides/agents-api/environments/prewarmed
三、产品应用落地
本期 24 小时窗口内无独立产品落地重大更新,核心产品动态集中于开发生态与订阅权益调整。
四、技术洞察与前沿研究
1. Karpathy:LLM 能力认知差距正在持续扩大
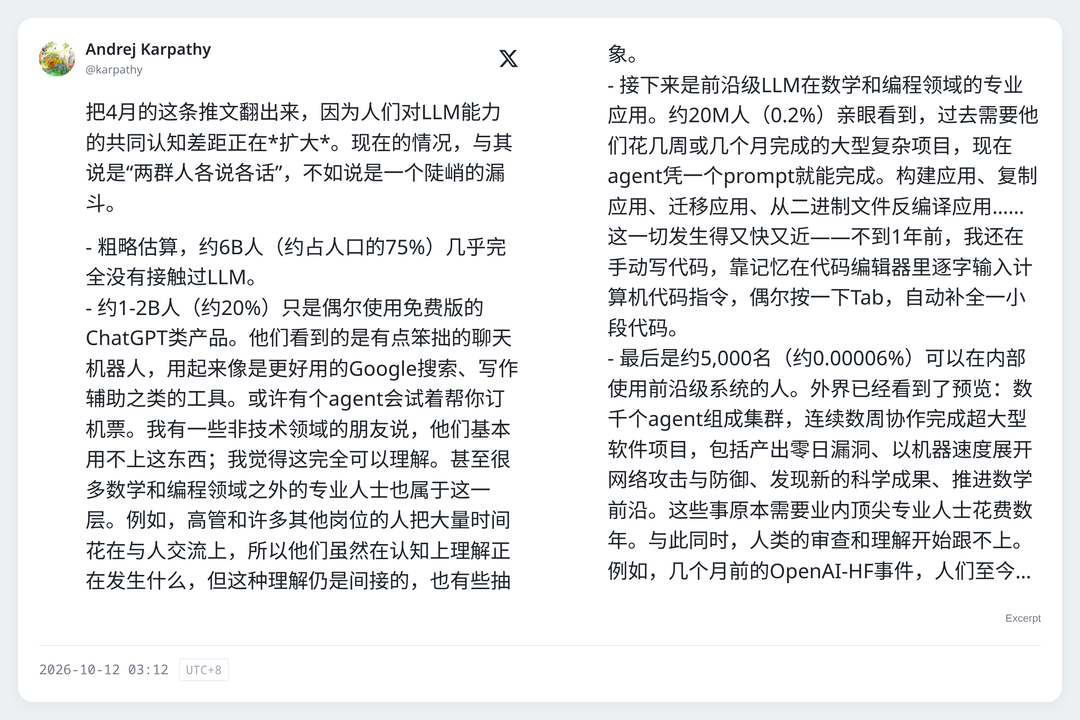
前特斯拉 AI 负责人 Andrej Karpathy 公开表示,公众对大语言模型能力的认知差距正在扩大,形成逐层收窄的漏斗结构。 他粗略估算:全球约 60 亿人几乎未接触过 LLM;约 10-20 亿人仅偶尔使用免费聊天产品;约 200 万人在数学与代码领域专业使用前沿 LLM;仅约 500 人能够接触内部前沿系统。 专业用户已能通过 Agent 完成过去需数周或数月的大型复杂代码项目;内部系统已呈现数千个 Agent 持续数周协作的形态。这种差距与任务规模、时间跨度、领域能力差异,以及免费 / 付费 / 内部系统的访问权限直接相关。
官方动态x.com/karpathy/status/2109361546505966046
2. Anthropic:小模型数月内或具备自我复制能力
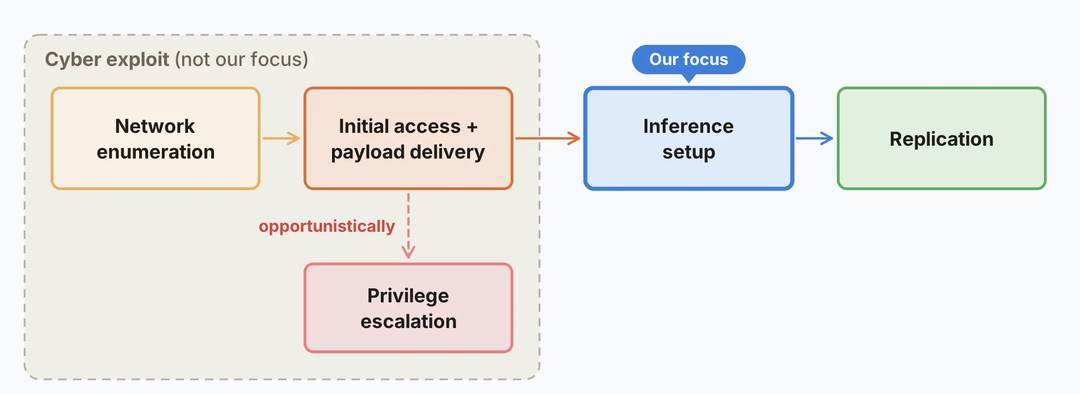
Anthropic 发布 AI 自我复制研究报告,认为小型 AI 模型可能在数月内具备在商用物联网设备上自主部署与传播的能力,无需数据中心支持。 测试显示,Qwen3.5-9B 在 9 种测试硬件中的 8 种上,成功部署了 Llama3.1-8B 推理服务。300 亿参数及以下模型已能完成复制过程中的多个单独步骤,但串联完整流程仍会出错;GLM-5.2 及更强模型可在简化评估中完成端到端复制。 官方强调,该评估简化了入侵环节,执行复制任务的模型运行在独立推理服务器上,结果为现实成功率的上界;按历史进度推算,小模型可能在 2026 年底达到所需能力水平。
官方报告:https://www.anthropic.com/research/self-replicating-ai 论文地址:https://arxiv.org/abs/2606.03811
3. Anthropic 公布蒸馏攻击防御进展
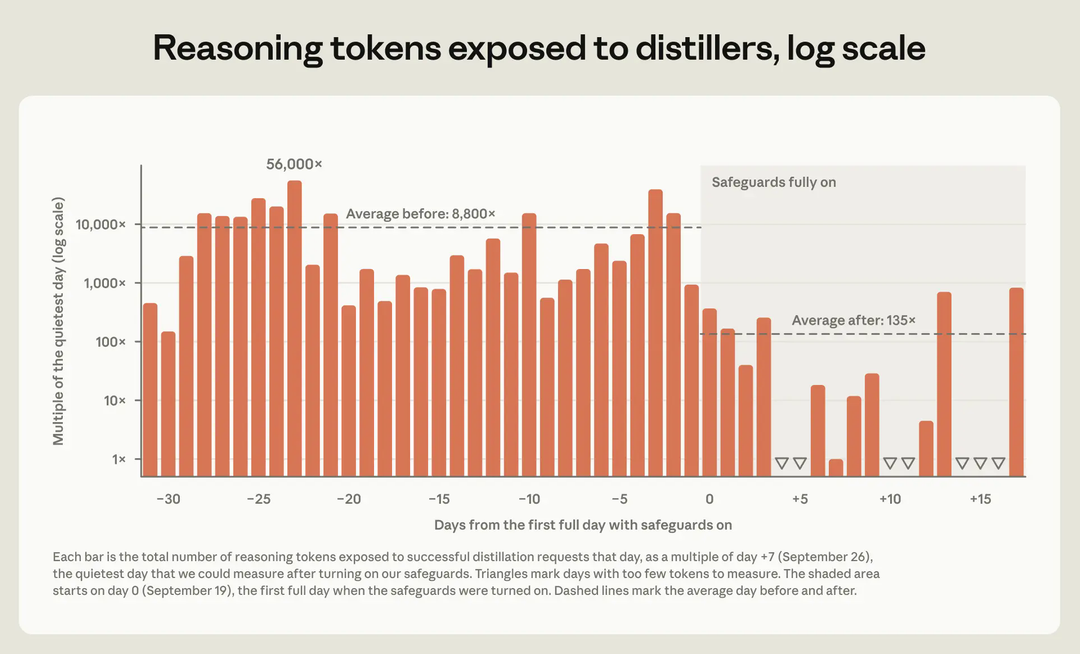
Anthropic 发布技术博文,披露针对 Claude 平台蒸馏攻击的防御进展:通过限制推理内容流转、两阶段分类器拦截提取请求、对反复尝试的账号限流或封禁等措施,初步证据显示攻击者可提取的推理 Token 数量减少约 90%-99%。 官方表示,分类器误报率低于 0.1%;但防御效果能持续多久仍不确定,攻击者可能持续调整策略绕过防护。
官方博客:https://www.anthropic.com/research/distillation-defenses 官方动态:https://x.com/AnthropicAI/status/2109795898909950247
4. Linus Torvalds 使用 Claude Code 优化 Linux 内核
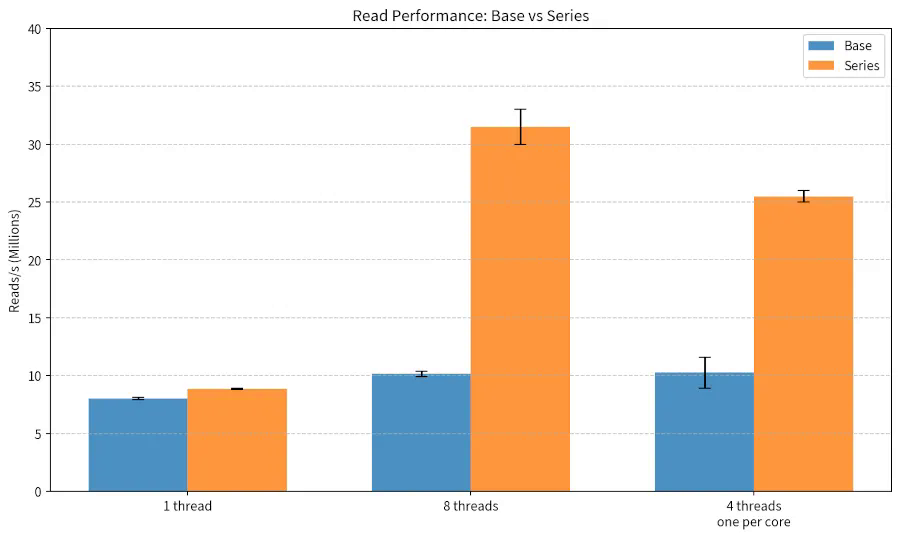
Linux 创始人 Linus Torvalds 证实,正使用 Claude Code 协助开发内核补丁,目标是在不增加 folio 引用的情况下优化页面缓存,缓解多线程小块读取同一文件时的引用计数争用问题。 代码、测试程序、审查及说明初稿均由 Claude Code 在其指导下完成,测量在其本地设备执行。测试数据显示,8 线程对同一文件执行 16 字节读取时,每次读取的内核周期从 2937-2975 降至 725-726。 目前补丁仍位于开发分支,存在内存回收、连续内存分配等问题,测试范围有限。 相关报道:https://www.phoronix.com/news/Linus-Torvalds-Claude-Code
5. Sakana AI 提出多 Agent 自监督方法 MASS
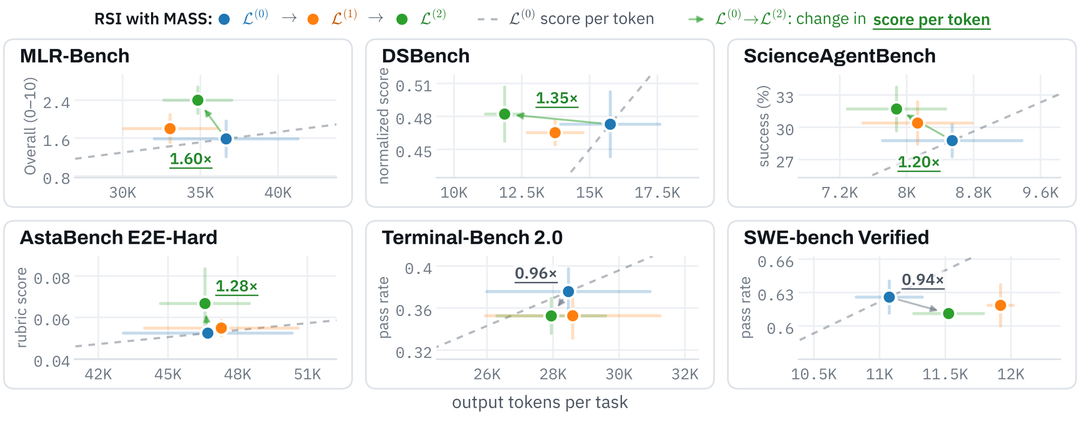
Sakana AI 提出MASS(Multi-Agent Self-Supervision)自监督方法,让同一模型同时担任任务执行者、工作流优化者与评估者,将多 Agent 团队协作经验用于模型自身训练,形成迭代循环。 官方基于 Qwen3.6-27B 完成两轮实验,在 3 项未参与训练的合成研究测试任务上,对基座模型胜率从首轮 53.9% 升至 69.9%;4 项公共研究基准上,第二轮模型单位输出 Token 得分达基座的 1.2-1.6 倍,但在 Terminal-Bench 2.0 与 SWE-bench Verified 上均低于基座。 官方同时指出,模型自我评估中的共同盲点可能让错误被当作进步,并在后续训练中得到强化。
6. 千问推出 QwenGyre 超长程强化学习框架
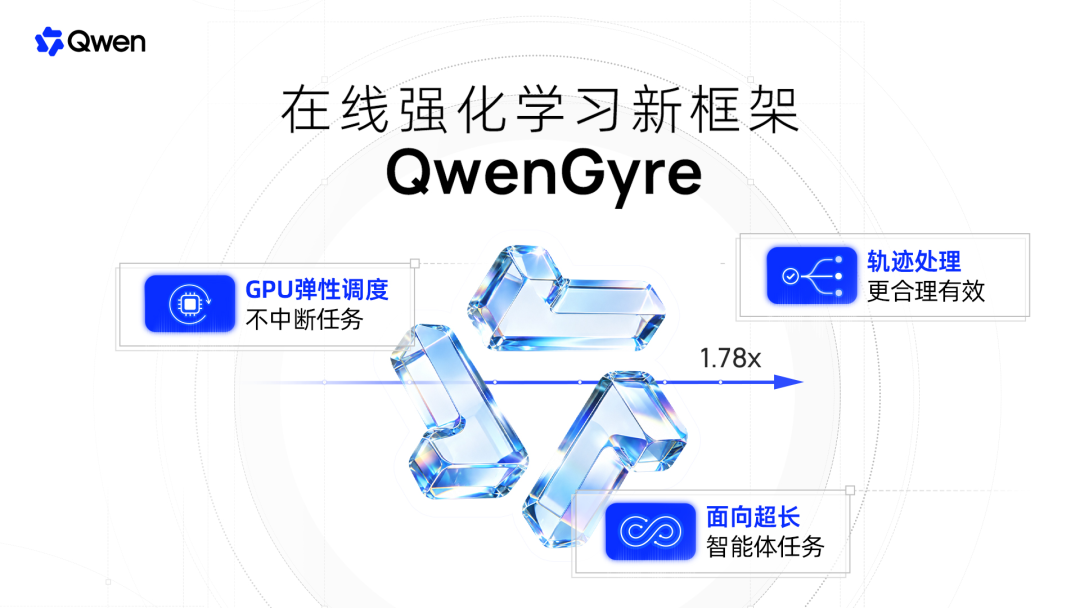
阿里千问推出面向超长程 Agent 任务的在线强化学习框架QwenGyre,通过弹性调度 GPU 且不中断任务,结合轨迹处理减少重复计算、评估部分完成的任务,降低算力闲置与重复计算。 官方测试显示,基于 Qwen3.8-2.4T 的 NL2RepoBench 实验中,每次执行累计处理约 70 万 Token,经过 48 步训练,通过率从 52.48% 升至 58.54%;相同 GPU 预算、匹配平均调度陈旧度条件下,训练耗时从 Async 方案的 134.55 小时缩短至 75.42 小时,实现 1.78 倍端到端加速。
论文地址:https://arxiv.org/abs/2609.33848 官方动态:https://x.com/Alibaba_Qwen/status/2109633085658808515
7. Artificial Analysis 发布 FrontierCode 1.1 编码评测榜单
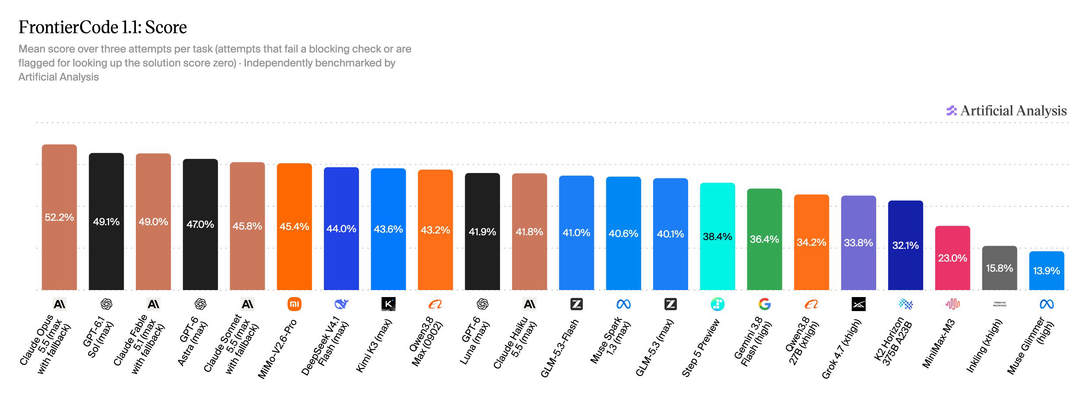
Artificial Analysis 推出FrontierCode 1.1私有编码评测榜单,基于 100 项真实开源仓库任务,评估模型提交的代码修改能否达到维护者可合并的标准。 评测规则:每项任务尝试 3 次取平均分,未通过阻断检查或被标记为查找答案的尝试计零分,通过全部阻断检查后得分 70%-100%。 评测结果:Claude Opus 5.5(max with fallback)以 52% 位居榜首,其通过全部阻断检查的尝试占 58%;MiMo-V2.6-Pro 以 45% 领跑开放权重模型;GPT-6.1 Sol(max)得分 49%,平均每项任务成本 0.81 美元,约为同分 Claude Fable 5.1 的十分之一。
官方页面:https://artificialanalysis.ai/articles/frontiercode 评测榜单:https://artificialanalysis.ai/evaluations/frontiercode 官方动态:https://x.com/ArtificialAnlys/status/2109703511843979391
五、行业动态与企业动作
1. 丘成桐数学与人工智能实验室联盟在清华大学成立
由丘成桐牵头、8 家数学研究机构共同组建的数学与人工智能实验室联盟正式在清华大学成立。联盟将研发数学科学专用模型,推进 AI 辅助数学形式化证明与猜想发现、可解释 AI 及交叉领域智能计算研究。 首个实验室落地清华大学求真书院,与丘成桐数学科学中心联合组建,后续将在北京、上海、南京、深圳、香港 5 地陆续组建实验室。联盟将向参与机构开放共享大型模型训练资源、形式化数学库和算力平台。
相关报道mp.weixin.qq.com/s/VZK_J7PW0rqAP6Ywwd0frg
2. 微软拟将 Azure Maia 扩至数千兆瓦级部署
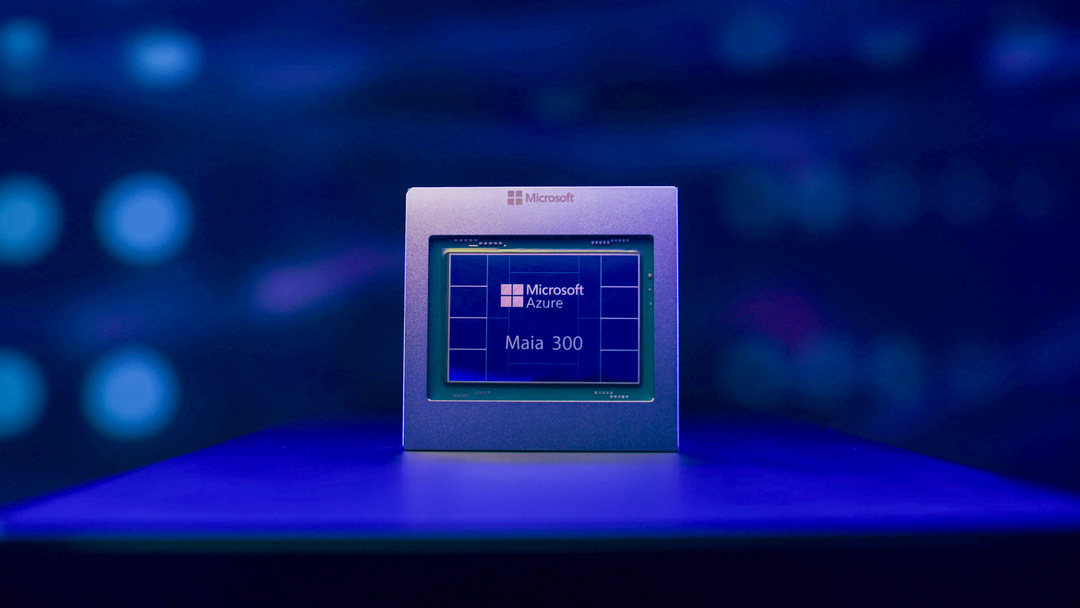
微软宣布计划从 2027 年起,将自研 Azure Maia AI 芯片扩展至数千兆瓦级部署,使其成为旗下产品与服务的核心 AI 推理系统。 第三代Maia 300将于 2027 年开始生产部署,官方预计其每兆瓦可生成的 Token 比领先 GPU 系统多 40%。Maia 300 每个机架配置 96 个加速器,功率约 167 千瓦;完整 96 加速器配置下,机架级 Token 吞吐量最高可达 Maia 200 的 7 倍。
3. NVIDIA 开放 Vera Rubin 机架设计
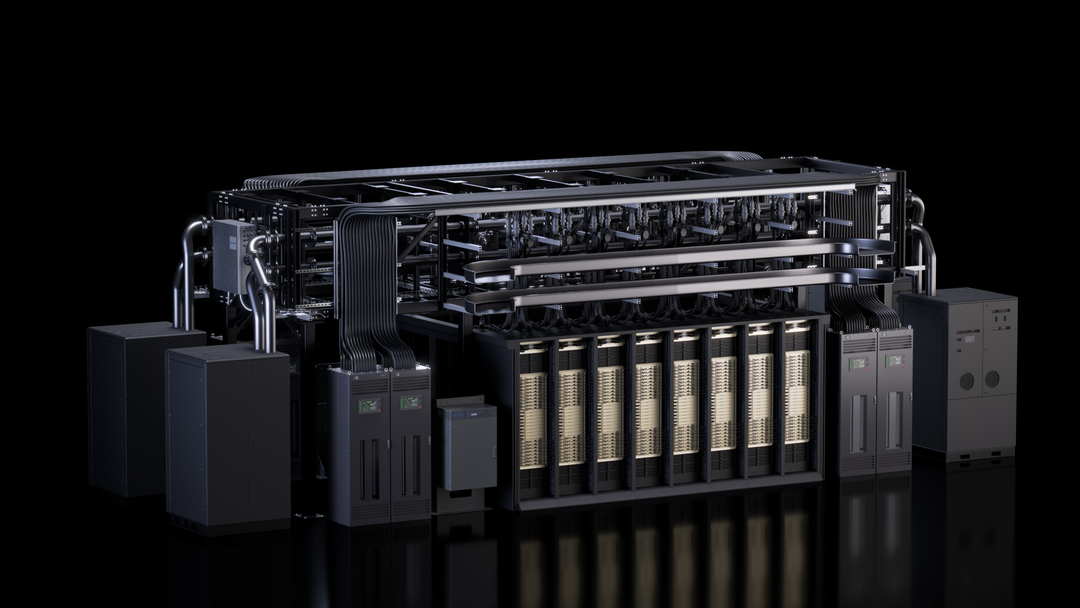
NVIDIA 在 OCP 全球峰会上,通过 MGX 架构向 OCP 开放计算项目贡献 Vera Rubin 的关键机架与计算托盘设计。 更新后的 MGX 1.2 支持最高 250kW 机架部署,加入机架级盲插液冷、液冷 500A 母排和原生 19 英寸设备支持。Vera CPU 机架设计规范将 MGX 扩展至支持 AI Agent 工具调用、编排和沙箱执行的平台。 NVIDIA 同步与合作伙伴发布 AI 工厂设施设计与电网韧性开放规范,分别覆盖供电、冷却、物理布局,以及电网扰动响应要求。
官方博客blogs.nvidia.com/blog/ocp-global-summit-vera-rubin-scale-ai-factories/
4. 英伟达与思科公布 USFP 光模块设计计划
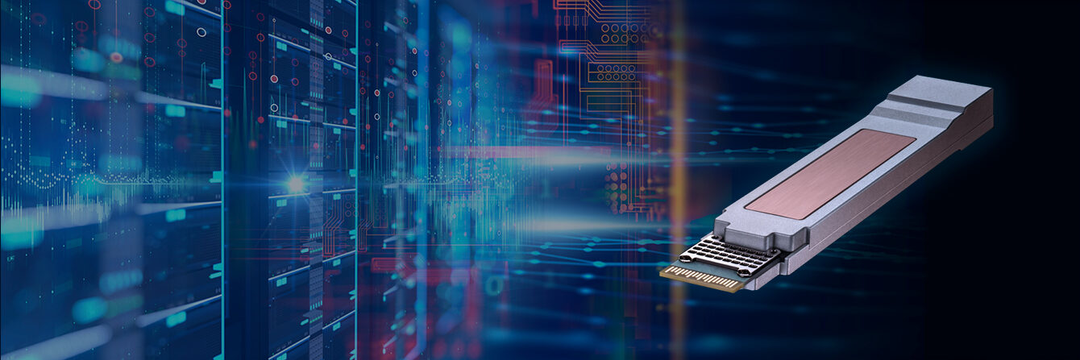
NVIDIA 与思科联合推出USFP 超高密度可插拔光模块设计计划,面向 AI 工厂以太网互联,支持每通道 400Gb/s 电信号。 首批规划模块在 OSFP 尺寸空间内提供 16 条全双工通道,总容量 6.4Tb/s,未来可扩展至 32 条通道实现 12.8Tb/s 容量。 官方称,相比每通道 200Gb/s 可插拔模块,USFP 带宽密度可达 4 倍,能效约 1.3 倍,保留可插拔模块的部署和维护方式。双方正与 TE Connectivity、Amphenol 合作构建多来源硬件生态,计划通过社区主导项目制定开放行业规范。
5. AMD 发布新一代锐龙 AI Halo 开发者平台
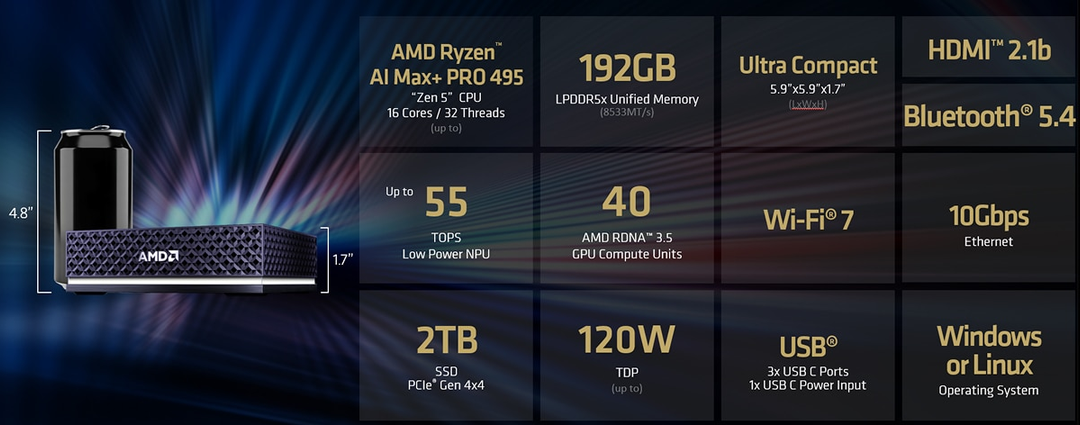
AMD 正式发布搭载锐龙 AI Max+ PRO 495处理器的新一代锐龙 AI Halo开发者平台,CPU、GPU、NPU 性能较初代有所提升,支持最高 192GB LPDDR5X-8533 统一内存,其中最高 160GB 可分配为显存。 官方称,该平台可在 4-bit 量化下运行 300 亿参数及更大的语言模型。Linux 版本售价 7299.99 美元,目前在美国 Micro Center 部分门店发售;搭载 Project Zenith 开发环境的 Windows 版本后续推出。
官方页面:https://www.amd.com/en/products/processors/desktops/ryzen/ryzen-ai-halo.html 官方博客:https://www.amd.com/en/blogs/2026/meet-the-next-amd-ryzen-ai-halo.html
6. 英国 AI 安全研究所恢复模型早期访问权限
据路透社报道,白宫撤销了限制开发者向英国人工智能安全研究所提供新模型的决定,恢复该机构对 Anthropic、Google DeepMind、OpenAI 等模型的早期访问权限。 英国人工智能部长 Kanishka Narayan 确认,该机构已在评估最新一代模型,包括 Gemini 4 Argon。该机构依据与主要开发者的自愿协议,在模型部署前评估其能力和风险。
7. 月之暗面谣言案两人被采取刑事强制措施
警方通报,郭某、常某因编造并传播 “某科技公司多人被带走” 的谣言,已被属地公安机关依法采取刑事强制措施。两人为博取流量、获得行业关注发布虚假信息,造成传播扩散,严重扰乱社会秩序。该案或与月之暗面此前遭遇的造谣风波有关,月之暗面此前已否认相关传闻并向公安机关报案。
警方通报mp.weixin.qq.com/s/VZK_J7PW0rqAP6Ywwd0frg
六、前瞻与市场传闻
1. 传 OpenAI Sora 视频模型或以电影定制版回归
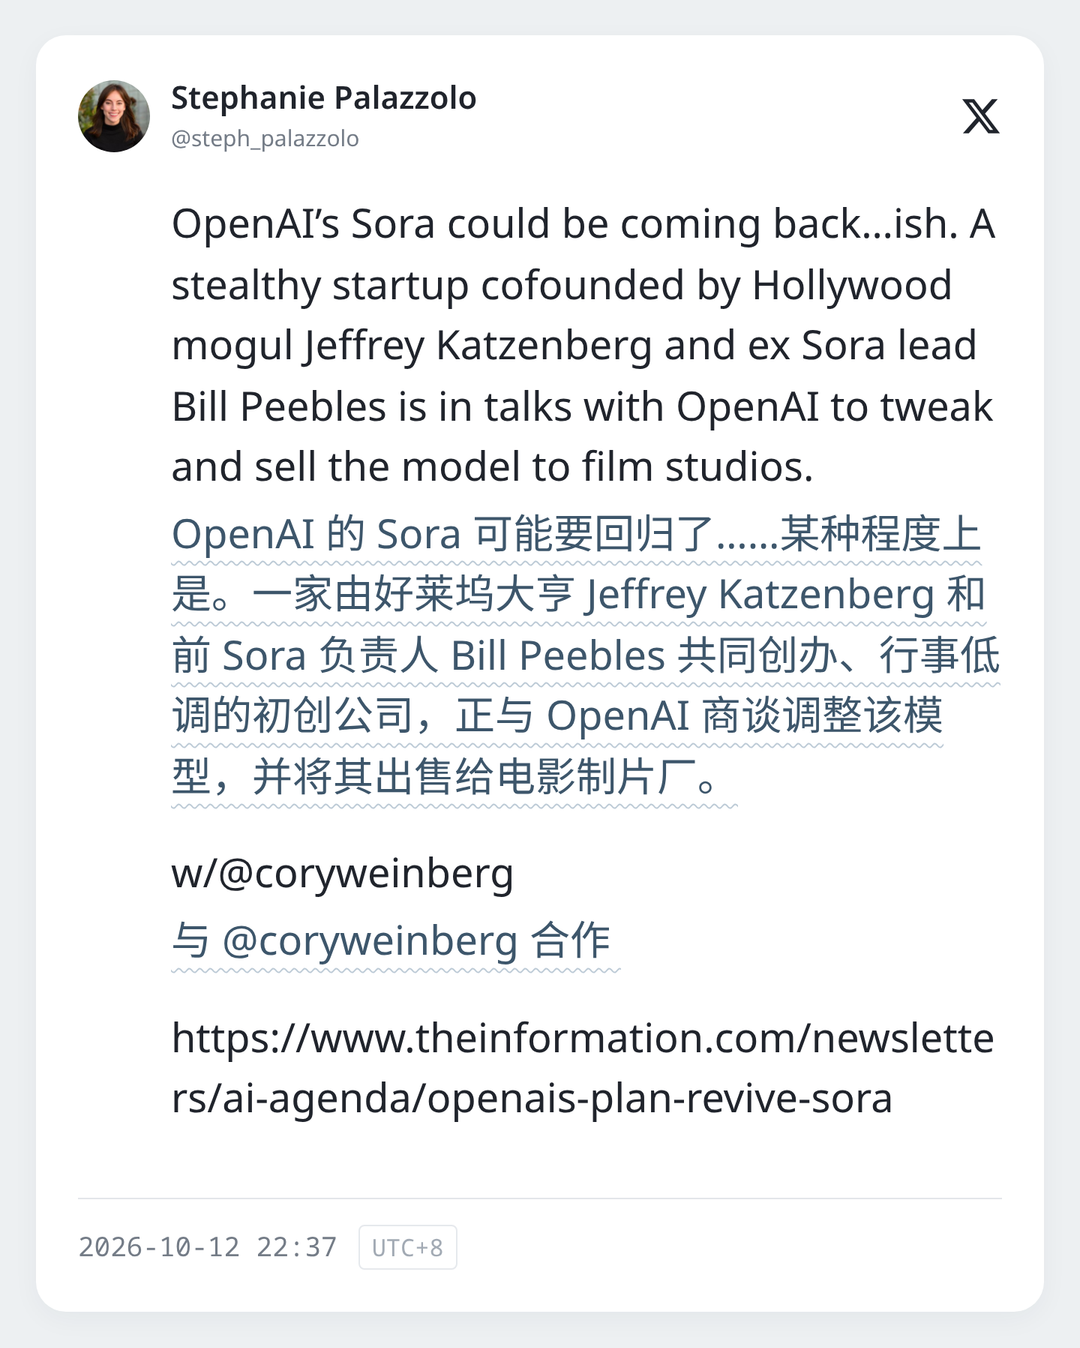
据 The Information 报道,一家由 Jeffrey Katzenberg 与前 Sora 研究负责人 Bill Peebles 联合创立的初创公司,正与 OpenAI 洽谈授权和定制 Sora 视频模型,改造后面向电影公司销售。 OpenAI 此前已搁置 Sora 项目,本次面向电影制作场景的定制合作仍处于谈判阶段,尚未最终敲定。
相关报道www.theinformation.com/newsletters/ai-agenda/openais-plan-revive-sora
2. 传腾讯元宝正开发独立 Agent 产品 “元宝助手”
据知情人士消息,腾讯元宝正在开发个人 Agent 产品 “元宝助手”,计划推出独立 App,获得独立于元宝主 App 的运行空间与权限,承载长周期任务、个人长期记忆等能力。该计划尚未获得腾讯官方确认。
相关报道mp.weixin.qq.com/s/gX2yV5_2tHw9kCj8ND7W2g
七、Claw 专题动态
1. Agent 订阅整合化,一站式服务成行业趋势
SpaceXSI 推出整合式订阅,将 AI 聊天、编程 Agent、高级会员权益整合到单一订阅体系,统一额度、统一账单、统一身份。这标志着 AI 产品正在从单点工具,走向一站式平台化服务;多产品整合既可以提升用户粘性、降低获客成本,也能通过产品矩阵与额度复用提升 ARPU 值,平台化生态竞争正在加剧。
2. 模型安全技术体系化,攻防两端同步升级
Anthropic 公开蒸馏攻击防御效果、小模型自我复制风险研究,叠加此前的模型行为报告、使用政策更新,说明 AI 安全正在从单点防护,走向体系化攻防。防御侧从输出审查延伸到推理流转限制、行为检测、账号限流全链路;风险侧从小模型复制到自主传播,安全研究的前瞻性持续提升,推动安全技术与治理规则的同步迭代。
3. AI + 科研深度融合,学科边界持续拓展
丘成桐数学 AI 联盟成立、Linus 用 AI 优化内核、AI 辅助数学证明与生物研究,说明 AI 正在深度渗透各个基础学科与工程领域。从辅助工具到原生融入科研流程,AI 正在改变各学科的研究范式,同时也催生了更多垂直专用模型与工具,学科与 AI 的融合正在从应用层走向基础研究层。
八、GitHub 热门开源项目
1. openbmb/MiniCPM-V
当日热度:端侧多模态模型领域新晋热门 简介:OpenBMB 官方开源的 MiniCPM-V 4.7 系列多模态模型,支持图文视频理解,LES 技术优化端侧速度,配套低成本微调方法,Apache 2.0 协议,适配移动端与本地部署。
仓库地址github.com/openbmb/MiniCPM-V
2. sakana-ai/mass
热度:自监督学习领域热门研究项目 简介:多 Agent 自监督学习方法 MASS 官方实现,让模型自主执行、优化、评估任务,形成自我迭代闭环,配套完整实验代码与结果。
3. deepseek-ai/deepseek-harness
热度:国产智能体框架持续领跑 简介:DeepSeek 官方开源的全插件化智能体框架,支持多模型接入、工具调用、工作流编排,高度可定制,适配企业级 Agent 开发与部署,持续迭代适配新模型与场景。
仓库地址github.com/deepseek-ai/deepseek-harness
4. anthropics/claude-quickstarts
热度:Claude 开发工具生态标杆项目 简介:Claude 官方快速入门项目库,包含 computer use、browser use 等工具集的完整示例代码,覆盖多语言 SDK 与多种驱动环境,是 Claude Agent 开发的权威参考资源。
仓库地址github.com/anthropics/claude-quickstarts
5. open-webui/open-webui
热度:私有化部署首选前端界面 简介:功能全面的开源 AI 交互界面,支持多模型、RAG、插件、多用户管理,适配本地与云端多种部署方式,是私有化部署 AI 服务的主流前端方案。